GPU의 기본개념과 최적화 방안
GPU의 구조와 개념
GPU의 발전
SISD, SIMD, MISD, MIMD
GPU의 발전을 이야기하려면, 먼저 병렬 컴퓨팅(Parallel Computing) 기술부터 살펴볼 필요가 있습니다. 병렬 컴퓨팅은 작업 속도를 높이기 위해 여러 개의 프로세서가 동시에 연산을 수행하는 기술입니다. 즉, 하나의 큰 작업을 여러 개의 작은 단위로 나누어 동시에 처리함으로써 전체 처리 시간을 단축시키는 방식입니다.
병렬 컴퓨팅을 분류하는 대표적인 기준으로는 플린의 분류(Flynn’s Taxonomy) 가 있습니다. 플린은 명령어(instruction) 와 데이터(data) 의 흐름을 기준으로 컴퓨터 구조를 네 가지로 나누었습니다. 바로 SISD, SIMD, MISD, MIMD입니다.
SISD (Single Instruction, Single Data)
하나의 프로세서(또는 명령어)가 하나의 데이터 흐름을 순차적으로 처리하는 구조입니다. 가장 전통적인 형태의 컴퓨터 구조로, 일반적인 싱글 코어 CPU가 여기에 해당합니다.
SIMD (Single Instruction, Multiple Data)
하나의 명령어가 여러 개의 데이터를 동시에 처리하는 구조입니다. 벡터 연산이나 병렬 처리에 적합하며, 현재의 GPU 구조가 대표적인 예입니다.
MISD (Multiple Instruction, Single Data)
여러 개의 명령어가 하나의 데이터를 처리하는 구조입니다. 실제로는 거의 사용되지 않는 형태로, 특수한 목적의 시스템에서 제한적으로 적용됩니다.
MIMD (Multiple Instruction, Multiple Data)
여러 개의 명령어가 여러 개의 데이터를 동시에 처리하는 구조입니다. 멀티코어 CPU가 대표적인 예로, 하나의 칩 안에 여러 개의 SISD 구조가 병렬로 동작하는 형태라고 볼 수 있습니다.
그래픽스의 발전과 GPU의 발전 방향
컴퓨터의 하드웨어는 각각 고유한 역할과 특성을 가지고 있습니다. 예를 들어 주기억장치(RAM)와 보조기억장치(Storage) 는 속도와 용량 간의 트레이드오프(trade-off) 관계를 가지고 있으며, 이러한 특성에 따라 각기 다른 용도로 발전해왔습니다.
이미지, 영상, 3D 그래픽, 게임 등 그래픽스 처리(Graphics Processing) 가 본격적으로 등장하면서, 단순한 연산을 대량으로 병렬 수행할 필요성이 커졌습니다. 예를 들어 이미지는 수많은 픽셀(pixel) 로 이루어져 있고, 각 픽셀은 RGB 3차원 벡터로 표현됩니다. 이미지 변환이나 필터링 같은 작업을 수행하려면 모든 픽셀에 대해 선형변환(linear transformation) 연산을 적용해야 합니다.
이 연산 자체는 복잡하지 않지만, 모든 픽셀에 대해 동시에 수행되어야 효율적이라는 점에서 병렬 처리가 필수적입니다. 이러한 문제를 해결하기 위해 등장한 장치가 바로 GPU(Graphics Processing Unit) 입니다.
GPU는 연산 유닛이라는 점에서 CPU와 유사하지만, 연산의 성격과 목표가 다릅니다.
- CPU 는 비교적 복잡하고 다양한 연산을 빠르게 처리하는 데 최적화된 반면,
- GPU 는 단순하지만 대량의 연산을 동시에 처리하는 데 초점을 맞추어 발전해왔습니다.
CPU는 클럭 속도(Clock Speed) 를 높여 단일 연산의 속도와 응답성을 향상시키는 방향으로 발전해왔습니다. 반면 GPU는 연산 코어의 수를 늘려, 한 번에 처리할 수 있는 연산의 양을 극대화하는 방향으로 발전했습니다.
이러한 GPU의 구조적 특성을 플린의 분류(Flynn’s Taxonomy) 관점에서 다시 바라보면, GPU가 SIMD (Single Instruction, Multiple Data) 구조의 대표적인 예라는 것을 쉽게 이해할 수 있습니다. 즉, 하나의 명령어(예: 동일한 선형변환 연산) 를 다양한 데이터(픽셀들)에 동시에 적용하는 방식이 바로 GPU의 핵심 동작 원리입니다.
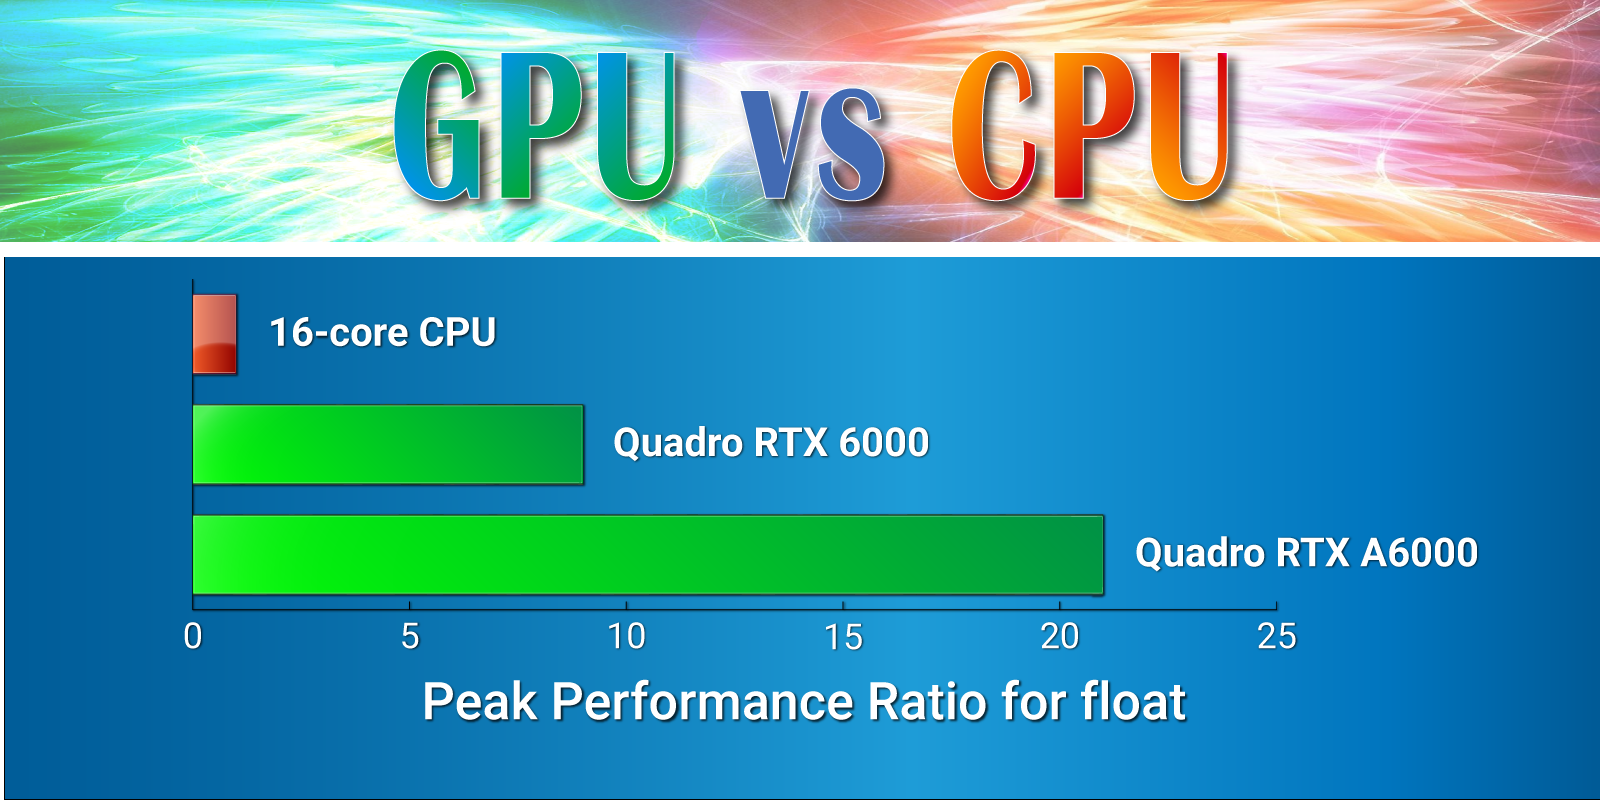
float 연산 기준 CPU와 GPU FLOPS 비율 비교: 32비트, 16비트 데이터에서 약 10배 더 빠르다.
GPU 플로우로 익히는 하드웨어의 기본 개념
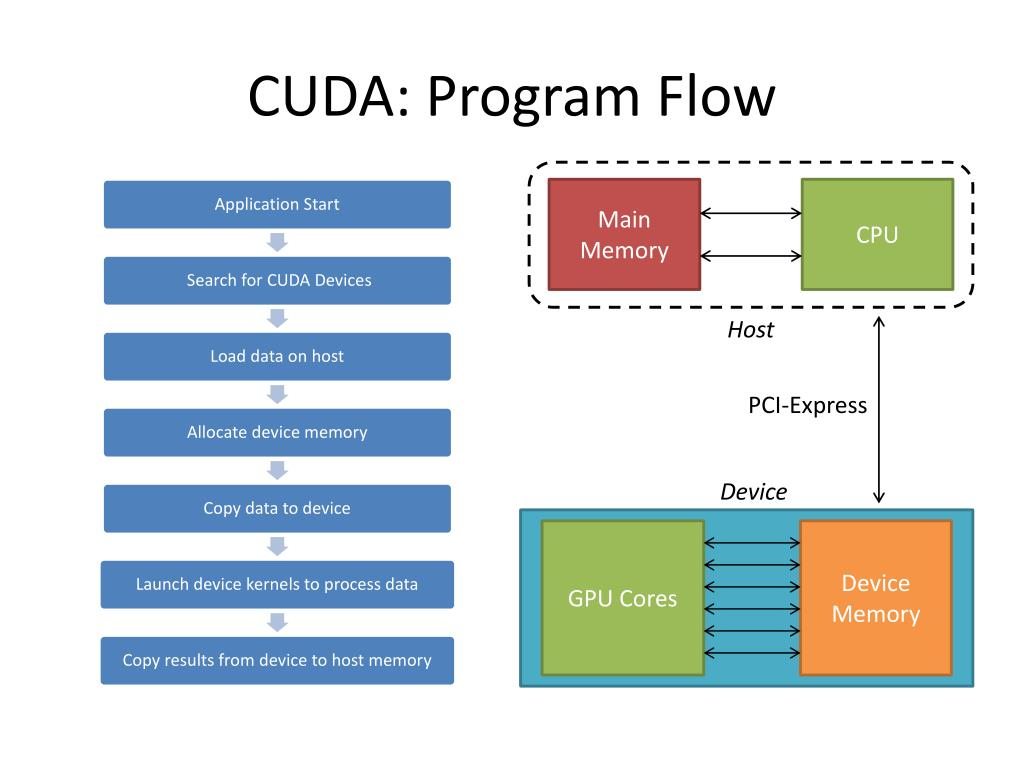
단순화한 GPU 연산 처리 과정
GPU에서 연산이 수행되는 기본적인 흐름은 다음과 같습니다.
- 메인 메모리(Main Memory) 에서 필요한 데이터를 로드합니다.
- 로드한 데이터를 GPU 메모리(Device Memory) 로 복사합니다.
- CPU는 GPU에 연산 명령을 전달합니다.
- GPU는 자신의 메모리에서 데이터를 가져와 병렬로 연산을 수행합니다.
- 처리된 연산 결과를 GPU 메모리에서 메인 메모리로 복사합니다.
보다 자세한 이해를 위한 용어 설명
GPU의 내부 구조와 동작 방식을 이해하기 위해 자주 등장하는 핵심 용어들을 정리했습니다.
1. Host와 Device
- Host: GPU에게 명령을 내리는 주체를 의미합니다. 일반적으로 CPU를 가리킵니다.
- Device: Host로부터 명령을 받아 실제 연산을 수행하는 장치로, GPU를 의미합니다.
2. HBM(High Bandwidth Memory)과 VRAM
- Device Memory, 즉 GPU에서 사용하는 전용 메모리를 의미합니다.
- GPU 코어는 병렬 연산을 위해 동시에 여러 데이터에 접근해야 하므로, 데이터를 빠르게 전달할 수 있는 높은 대역폭(Bandwidth) 이 매우 중요합니다.
- 이를 위해 GPU는 한 번에 많은 양의 데이터를 전송할 수 있는 HBM(High Bandwidth Memory) 을 사용합니다.
- 그럼에도 불구하고, 일반적으로 메모리 → 코어 간 데이터 전송 속도가 GPU의 연산 속도보다 느리기 때문에, 이 구간이 병목(Bottleneck) 으로 작용하기도 합니다.
3. Kernel
- Kernel은 CPU가 CUDA를 통해 GPU에 연산을 요청하는 작업 단위 혹은 함수를 의미합니다.
- 커널이 호출되면 CUDA 런타임은 해당 연산을 블록 단위로 재구성하고, 효율적으로 병렬 처리될 수 있도록 스케줄링합니다.
4. Thread, Warp, Block, Grid
- Thread: GPU에서의 가장 작은 실행 단위입니다. 각 스레드는 독립적으로 연산을 수행하며, 고유한 레지스터를 통해 중간 연산 값을 저장할 수 있습니다. 커널 코드는 모든 스레드에 공통으로 적용됩니다.
- Warp: 32개의 스레드로 구성된 그룹입니다. GPU의 기본 실행 단위이며, 하나의 워프에 속한 모든 스레드는 하나의 명령어를 동시에 실행합니다. 이를 SIMT(Single Instruction, Multiple Thread) 구조라고 합니다.
- Block: 여러 워프를 묶은 상위 단위입니다. 하나의 블록은 최대 32개의 워프로 구성될 수 있습니다. 하나의 SM(Stream Multiprocessor) 내에서 실행되며, 블록 내의 스레드들은 공유 메모리(SRAM) 에 접근할 수 있습니다.
- Grid: CUDA 스레드 계층 중 가장 상위 단위입니다. 여러 블록으로 구성되며, 커널이 실행될 때 함께 생성됩니다. 하나의 Grid는 하나의 커널 호출과 1:1로 대응되어, 해당 커널을 실행할 모든 스레드를 포함합니다.
5. SM (Streaming Multiprocessor)
- 실제로 연산을 수행하는 GPU 내부의 실행 유닛입니다.
- 하나의 SM은 여러 스레드 블록을 동시에 관리하며, GPU의 병렬 연산 성능을 결정하는 핵심 요소입니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
+---------------------------------------------------------------------------------+
|                               Global Memory (VRAM)                              |
|                            (~40 GB, ~1.5 TB/s on A100)                          |
+----------------------------------------+----------------------------------------+
                                         | (Slow off-chip bus)
+----------------------------------------v----------------------------------------+
|                            Streaming Multiprocessor (SM)                        |
|                     (1 of 108 SMs on an A100, each ~(19.5/108) TFLOPS)          |
|                           (2048 threads, 64 warps, 32 blocks)                   |
| +-----------------------------------------------------------------------------+ |
| |                        Shared Memory (SRAM) / L1 Cache                        |
| |                    (~192 KB on-chip workbench, 19.5 TB/s)                     |
| +-----------------------------------------------------------------------------+ |
| |                        Register File (~256 KB, ? TB/s)                        |
| +-----------------------------------------------------------------------------+ |
| |                                                                             | |
| |                //-- A "Block" of threads runs on one SM --//                | |
| | +--------------------------+ +------------------------+                     | |
| | |      Warp 0 (32 thr)     | |      Warp 1 (32 thr)   | ... (up to 32 warps)| |
| | | +----------------------+ | +----------------------+ |                     | |
| | | | Thread 0 Registers   | | | Thread 32 Registers  | |                     | |
| | | | [reg0: float]        | | | [reg0: float]        | |                     | |
| | | | [reg1: float] ...    | | | [reg1: float] ...    | |                     | |
| | | +----------------------+ | +----------------------+ |                     | |
| | +--------------------------+ +------------------------+                     | |
| |                                                                             | |
+---------------------------------------------------------------------------------+
용어를 사용한 보다 자세한 GPU의 연산 처리과정
| 단순화한 GPU 연산 처리 과정 | 용어를 사용해서 다시 정리한 과정 |
|---|---|
| 1. 메인 메모리에 데이터를 로드한다. | Host에서 메인 메모리에 데이터를 로드한다. |
| 2. GPU 메모리에 데이터를 복사한다. | VRAM(HBM)으로 메모리를 복사한다. |
| 3. CPU는 연산을 지시한다. | Host는 Device에게 kernel을 호출한다. CUDA는 kernel을 전달받아 SM 단위로 수행할 그리드를 생성한다. |
| 4. GPU는 GPU메모리에서 데이터를 가져와 병렬로 처리한다. | SM은 VRAM(HBM)에서 데이터에 접근해 병렬로 처리한다. 그리드 내의 스레드는 Shared Memory(SRAM)을 공유하며 결과를 저장하거나 재활용하며 코어와 VRAM 사이의 통신비용을 최소화한다. |
| 5. 연산결과를 GPU 메모리에서 메인메모리로 복사한다. | 코어의 연산결과는 SM → VRAM → 메인메모리 순으로 복사되어 전달된다. |
효율적 병렬처리
비효율의 세 가지 원인
메모리 바운드 (Memory Bound)
앞서 언급했듯이, GPU의 연산 속도는 매우 빠르지만 메모리 접근 속도는 상대적으로 느리기 때문에 병목이 발생할 수 있습니다.
예를 들어 NVIDIA A100의 경우, 초당 약 $19.5 \times 10^{12}$개의 32비트 부동소수점 연산(FP32)을 수행할 수 있습니다. 반면, 메모리 대역폭은 약 $1.5 \text{ TB/s}$에 불과합니다. 이를 단순화해보면, 단일 4바이트(32비트) 데이터를 읽는 시간 동안 GPU는 50회 이상의 연산을 수행할 수 있는 속도를 가지고 있습니다.
즉, 연산보다는 데이터 접근 과정이 상대적으로 느려서 GPU 코어가 데이터를 기다리는 시간이 더 길어지는 것입니다. 이처럼 메모리 접근 지연으로 인해 GPU가 유휴 상태(idle state) 에 머무는 상황을 메모리 바운드(Memory Bound) 라고 합니다.
예를 들어, 다음과 같은 단순한 element-wise 연산을 생각해볼 수 있습니다.
\(y = x + 1\) 이 경우, 각 SM(Stream Multiprocessor)은 읽어온 각 요소(element)에 대해 매우 단순한 연산만 수행합니다. 따라서 대부분의 시간은 데이터를 기다리며 비활성 상태(inactive) 로 남게 됩니다.
컴퓨트 바운드 (Compute Bound)
반대로, 연산이 복잡하고 불규칙하여 코어의 계산 처리 속도 자체가 병목이 되는 경우를 컴퓨트 바운드(Compute Bound) 라고 합니다. 이때는 데이터는 충분히 빠르게 전달되지만, 연산이 너무 복잡하거나 많아 GPU가 계산을 완료하는 데 시간이 오래 걸리는 상황입니다.
대표적인 예로 대규모 행렬 곱셈(Matrix Multiplication) 이 있습니다.
\(C = A \cdot B\) 이 경우, 데이터가 SM에 로드된 이후에는 막대한 양의 연산이 수행되며, SM이 계산을 수행하는 동안 메모리 버스는 오히려 유휴 상태로 남게 됩니다.
오버헤드 바운드 (Overhead Bound)
오버헤드 바운드(Overhead Bound) 는 GPU 자체가 아니라, 어플리케이션 레벨에서 CPU가 연산 요청을 관리하거나 커널을 실행하는 과정에서 발생하는 병목 현상을 말합니다. 즉, GPU가 일을 할 준비가 되어 있음에도 불구하고, CPU가 커널을 실행하거나 스케줄링하는 데 시간이 걸려 전체 처리 속도가 늦어지는 상황입니다.
다만 최근의 딥러닝 프레임워크(PyTorch, TensorFlow 등)는 비동기(Asynchronous) 요청을 통해 이러한 CPU 오버헤드를 대부분 완화하고 있습니다.
비효율의 원인을 해결하는 방법들
Fusion
연속적인 메모리 바운드 연산 작업이 존재할 때, 각 연산이 순차적으로 실행되면 메모리와 코어 간 병목이 발생합니다. 이를 완화하기 위해 여러 연산을 하나의 커널로 결합하여 불필요한 메모리 왕복을 제거하는 최적화 기법을 Fusion 이라 합니다.
예를 들어, 다음과 같은 단순한 연산 체인을 생각해볼 수 있습니다.
\(y = \text{ReLU}(x + 1)\) 각 연산(add, relu)은 연산 복잡도가 낮은 메모리 바운드 연산입니다. 이러한 연산을 각각 독립적인 커널로 실행하면 비효율적입니다. 대신 하나의 커널로 합쳐 실행하면 성능이 향상됩니다.
Fusion의 핵심은 두 연산을 하나의 커널 안에서 연속적으로 처리하는 것입니다. 예를 들어, $(x + 1) + 1$ 같은 단순 결합은 $x + 2$로 단일화할 수 있지만, 대부분의 경우는 하나의 커널 내에서 두 연산을 순차적으로 처리합니다.
실행 방식 비교
- Unfused Kernel
- Kernel 1 (add): 전역 메모리에서 텐서 $x$를 읽고, $tmp = x + 1$을 계산 후 $tmp$를 전역 메모리에 씀.
- Kernel 2 (relu): 전역 메모리에서 $tmp$를 다시 읽고, $y = \text{ReLU}(tmp)$를 계산 후 전역 메모리에 씀. → 즉, 중간 결과를 쓰고 읽기 위해 불필요한 전역 메모리 접근이 발생.
- Fused Kernel
- 단일 스레드가 $x$의 한 요소를 전역 메모리에서 읽음.
- 모든 계산($tmp = x + 1, y = \text{relu}(tmp)$)을 레지스터 내에서 수행.
- 최종 결과 $y$만 전역 메모리에 저장. → 불필요한 전역 메모리 접근이 제거되어 효율성이 향상됩니다.
Tiling
Tiling은 복잡한 컴퓨트 바운드 연산을 효율적으로 수행하기 위해 연산을 작은 타일 단위로 나누어 처리하는 최적화 기법입니다. 이는 SM 내부의 shared memory(온칩 메모리) 를 최대한 재사용하여, 중복된 글로벌 메모리 접근을 줄이는 방식입니다.
예시: 행렬 곱셈 두 $N \times N$ 행렬 $A$, $B$의 곱을 계산한다고 가정합니다. 만약 $N = 1024$라면, 32비트 부동소수점 기준 약 4MB의 데이터를 다뤄야 합니다. 그러나 A100 GPU의 SM당 shared memory는 164KB 정도에 불과합니다. 따라서 전체 데이터를 한 번에 온칩 메모리에 올릴 수 없습니다.
- Tiling을 적용하지 않으면, 각 스레드는 필요한 $A[i,k]$와 $B[k,j]$를 매번 글로벌 메모리에서 읽고, 한 번 사용 후 버리게 되어 데이터 재사용성이 매우 낮아집니다.
- 반면 Tiling을 적용하면, 작은 블록(타일) 단위로 데이터를 shared memory에 캐싱해두고, SM 내 스레드들이 이를 재사용할 수 있습니다.
비교 요약
- Tiling 사용: 스레드들이 작은 타일을 shared memory(작업대)에 올려두고 공유하며 작업. 데이터 접근이 연속적이고 빠르며, 재사용률이 높음.
- Tiling 미사용: 각 스레드가 거대한 글로벌 메모리(창고)에서 각자 데이터를 찾아다님. 데이터 접근이 비연속적이며, 대기시간이 길고 비효율적.
Quantization
Quantization(양자화) 는 텐서 값의 정밀도를 줄이는 방법으로, 예를 들어 FP32 → FP16 또는 BF16으로 변환하는 것을 의미합니다. 양자화는 크게 두 가지 장점을 가집니다.
- 메모리 사용 효율 향상
- FP32 → FP16으로 줄이면 데이터 크기가 절반(½) 으로 감소합니다.
- 따라서 shared memory에 더 많은 데이터를 저장할 수 있어, 한 번에 더 많은 데이터를 병렬 처리할 수 있습니다.
- 연산 성능 향상
- GPU는 낮은 정밀도(precision) 에서 더 높은 처리량(TFLOPS)을 달성합니다.
- 예를 들어 A100 GPU의 경우:
- FP32 연산: $19.5 \text{ TFLOPS}$
- FP16 연산: $312 \text{ TFLOPS}$
- 이론적으로 약 16배의 연산 성능 향상이 가능하며, 이를 통해 연산 병목을 완화하고 처리 속도를 극대화할 수 있습니다.
출처
- https://blog-flow.tistory.com/entry/🖥️-컴퓨터구조-SISD-SIMD-MIMD-SPMD-모델
- https://www.linkedin.com/pulse/how-compare-gpu-vs-cpu-performance-fast-image-fyodor-serzhenko/ $$